都内の不動産のデータをhereRを使って可視化・分析する

この記事はHERE Advent Calendar 2023の17日目の記事です。
Rでこんなパッケージを見つけた。試してみたいので記事を書くことにした。
HERE REST APIsをラップしているみたいで、ジオコーディングやら到達圏解析やらできるらしい。 作成者はスイス連邦鉄道のデータサイエンティストの方のようだ。
今回は不動産のデータをWebスクレイプしてhereRパッケージを使いつつ可視化・分析する。
データの取得
以下の記事を参考にし、suumoに掲載されているデータを取得させていただいた。
大量にデータを取得するとサーバに負荷がかかるので、取得するデータは都内のワンルームマンションだけにする。
なお、当該ウェブサイトの利用規約上に著作権に係る規定や禁止行為が明記されているので、当記事を参考にされる方がいれば事前に参照されたい。
以下のステップでWebスクレイプしている。
RでWebスクレイピングする際はrvestを使うと便利だ。 以下のコードでは、rvestに加えてこの後使うパッケージもロードし、スクレイプした各ページのデータをまとめた後に列名を適切なものに変更している。
# import packages to use
require(rvest)
require(tidyverse)
require(ggthemes)
require(DataExplorer)
require(patchwork)
require(hereR)
require(tmap)
require(tmaptools)
require(stringi)
require(sf)
require(geojsonsf)

# Scraping data from SUUMO
base_url <- ("https://suumo.jp/jj/bukken/ichiran/JJ010FJ001/?ar=030&bs=011&ta=13&jspIdFlg=patternShikugun&kb=1&kt=9999999&mb=0&mt=9999999&md=0&ekTjCd=&ekTjNm=&tj=0&cnb=0&cn=9999999&srch_navi=1")
html <- read_html(base_url)

max_page_num <- read_html(base_url) %>%
    html_elements(".pagination-parts") %>%
    html_elements("a") %>%
    html_text2() %>%
    as.integer() %>%
    max(na.rm = TRUE) %>%
    as.character()

header <- c("name", "price", "address", "line_station", "area", "room_type", "balcony", "year_built")

page_urls <- str_glue(str_c(base_url, "&page={1:", max_page_num, "}"))

scraper <- function(url) {
    read_html(url) %>%
        html_elements(".dottable--cassette") %>%
        html_elements("dd") %>%
        html_text2() %>%
        matrix(ncol = 8, byrow = TRUE) %>%
        as_tibble()
}

dat <- map(page_urls, scraper) %>%
    list_rbind() %>%
    rename_with(~ header)
データの整形
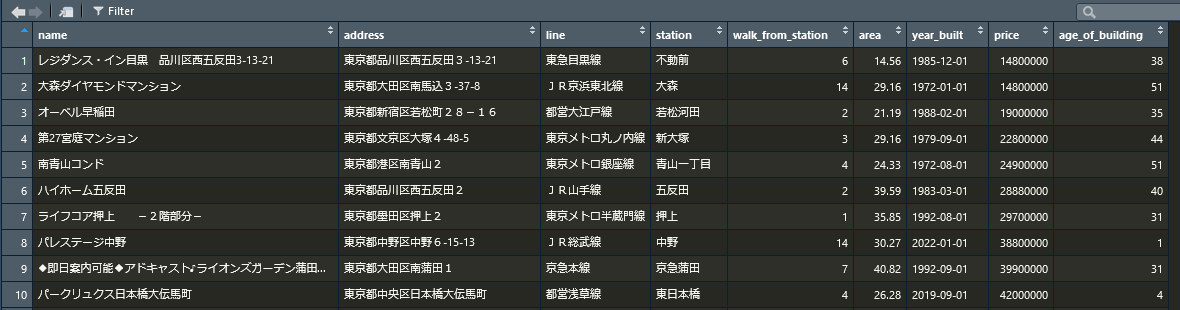
取得したデータでは価格に漢数字が使われていたり、最寄り駅の路線と駅名が同じカラムに入っていたりするので整形する。 数値は文字列になっているのでデータ型も変更し、築年数も計算している。
# Data cleansing
dat <- dat %>%
    separate(col = price, sep = "億", into = c("hundread_M", "ten_K"), fill = "left") %>%
    mutate(hundread_M = as.integer(hundread_M) * 100000000) %>%
    mutate(ten_K = str_extract(ten_K, "\\d+")) %>%
    mutate(ten_K = as.integer(ten_K) * 10000) %>%
    replace_na(replace = list(hundread_M = 0, ten_K = 0)) %>%
    mutate(price = hundread_M + ten_K) %>%
    separate(line_station, sep = "「", into = c("line", "station")) %>%
    separate(station, sep = "」", into = c("station", "walk_from_station")) %>%
    mutate(walk_from_station = str_extract(walk_from_station, "\\d+")) %>%
    mutate(walk_from_station = as.integer(walk_from_station)) %>%
    mutate(area = str_extract(area, "\\d+(?:\\.\\d+)?")) %>%
    mutate(area = as.numeric(area)) %>%
    mutate(year_built = str_replace(year_built, pattern = "年", replacement = "-")) %>%
    mutate(year_built = str_remove(year_built, pattern = "月")) %>%
    mutate(year_built = as_date(year_built, format = ("%Y-%m"))) %>%
    mutate(age_of_building = as.integer((Sys.Date() - year_built)/365)) %>%
    select(-c(hundread_M, ten_K, balcony, room_type))
整形後のしたデータは以下のようなものになる。
データの可視化(チャート)
データは用意できたのでとりあえず可視化していく。 チャートを作成する際はggplot2に加えてDataExplorerを使うと便利だ。
# Data exploration
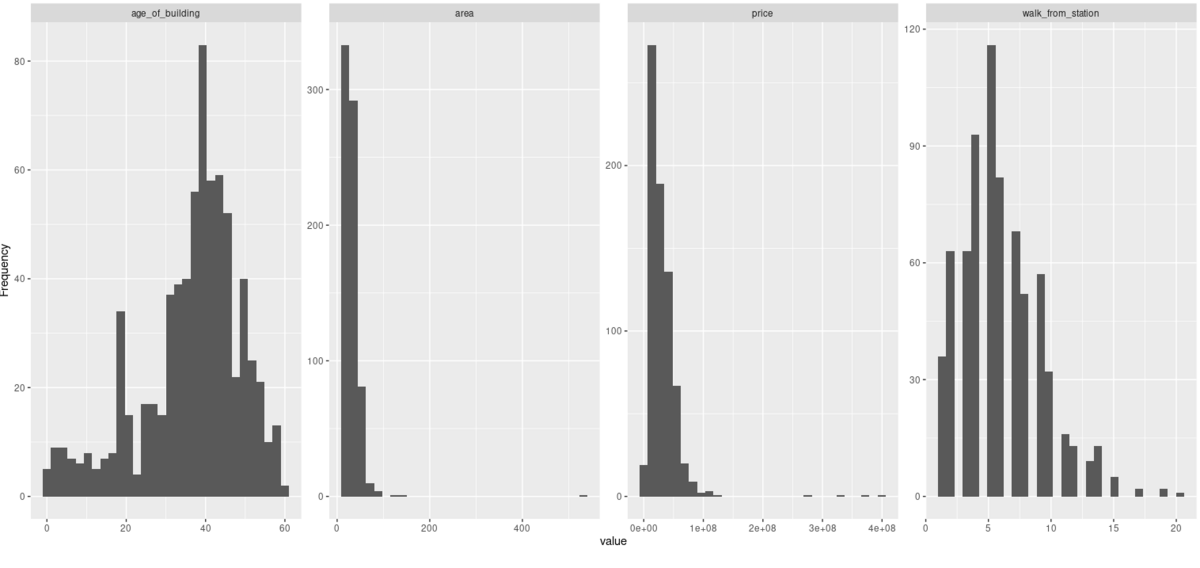
plot_histogram(dat)
plot_bar(dat)
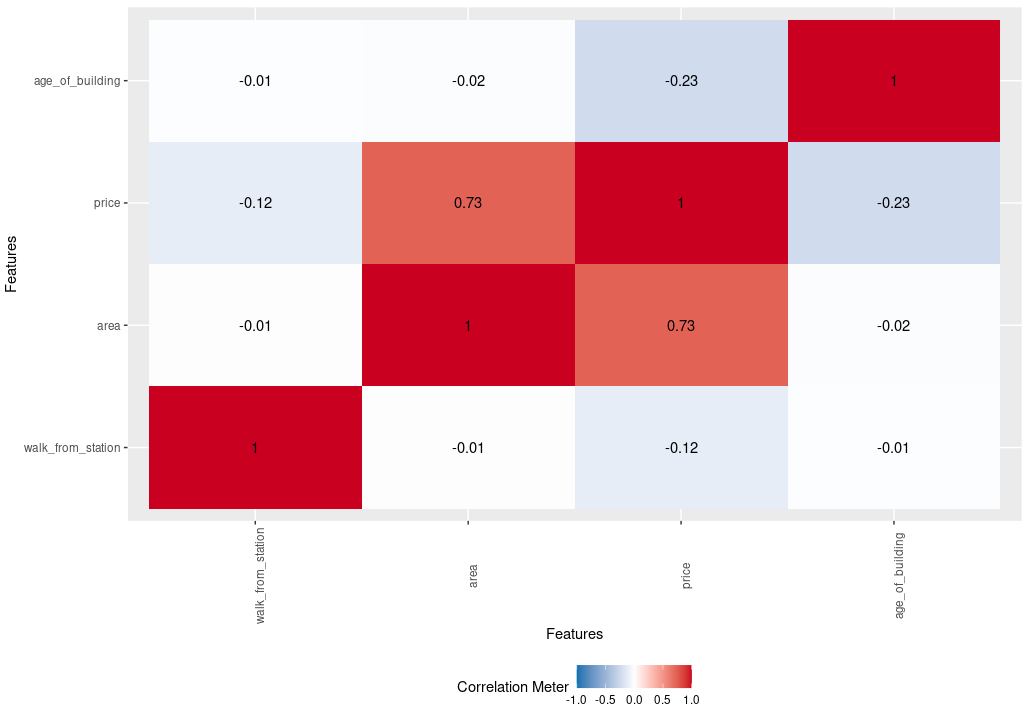
plot_correlation(dat)

g1 <- ggplot(dat, aes(x = area, y = price)) +
    scale_x_continuous(breaks = seq(0, 160, 10)) +
    geom_point() +
    theme_economist()
g2 <- ggplot(dat, aes(x = age_of_building, y = price)) +
    geom_point() +
    theme_economist()
g3 <- ggplot(dat, aes(x = walk_from_station, y = price)) +
    scale_x_continuous(breaks = seq(0, 20, 5)) +
    geom_point() +
    theme_economist()

g1 + g2 + g3 + plot_layout(ncol = 1)
ヒストグラムをみると築40年以上の物件がかなり多い。また、ワンルームなのにかなり広い物件が少数あるようだ。おそらく同じ物件だろうが価格も億を超える物件がある。
各変数事の相関係数を見ると価格と専有面積の相関係数が0.73で、築年数と最寄駅からの徒歩時間も若干負の相関がある。
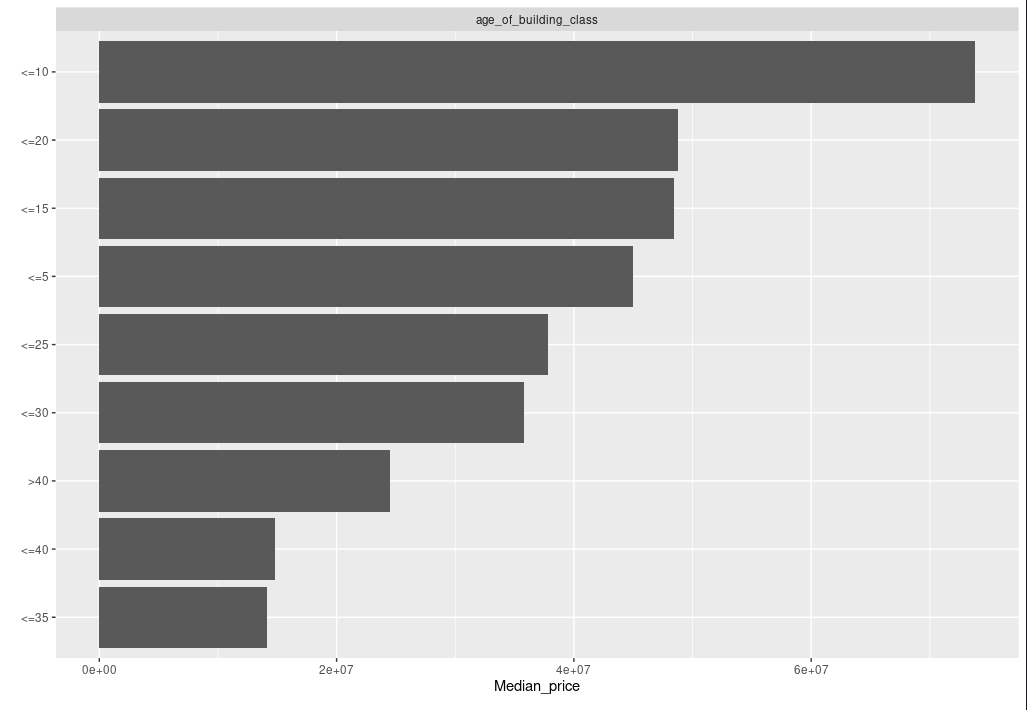
築年数の影響をもう少し確認したいので、グループ化して中央値をとる。
group_by_ages <- dat %>%
   mutate(age_of_building_class = case_when(age_of_building <= 5 ~ "<=5",
                                            age_of_building > 5 & age_of_building <= 10 ~ "<=10",
                                            age_of_building > 10 & age_of_building <= 15 ~ "<=15",
                                            age_of_building > 15 & age_of_building <= 20 ~ "<=20",
                                            age_of_building > 20 & age_of_building <= 25 ~ "<=25",
                                            age_of_building > 25 & age_of_building <= 30 ~ "<=30",
                                            age_of_building > 30 & age_of_building <= 35 ~ "<=35",
                                            age_of_building > 35 & age_of_building <= 40 ~ "<=40",
                                            age_of_building > 40 ~ ">40")) %>%
    group_by(age_of_building_class) %>%
    summarise(median_price = median(price))

plot_bar(group_by_ages, "median_price")
都内の物件であればある程度価格を維持していると思うがさすがに、25年を超えると下がってくる傾向がありそうだ。また、40年を超えた物件はかなり中央値が下がっている。
データの可視化(マップ)
マップで可視化するので、hereRを使ってジオコーディングする。 マップの表示にはtmapを使う。
ベースマップもカスタムできるので、HEREのラスタータイルを使用しよう。 以下のコードでは試しに「東京都」でジオコーディングして返却されたポイントを可視化している。データはsf形式で返却されるので、そのままtmapの関数にデータを渡すことができる。
# Map visualization
key <- "YOUR_API_KEY"
set_key(key)
basemap_endpoint <- paste0("https://maps.hereapi.com/v3/base/mc/{z}/{x}/{y}/png?style=lite.day&apiKey=", key)

tokyo <- geocode(address = "東京都")

tmap_mode("view")
tm_shape(tokyo) +
    tm_dots(col = "#CC6666", size = 0.15) +
    tm_basemap(server = basemap_endpoint)
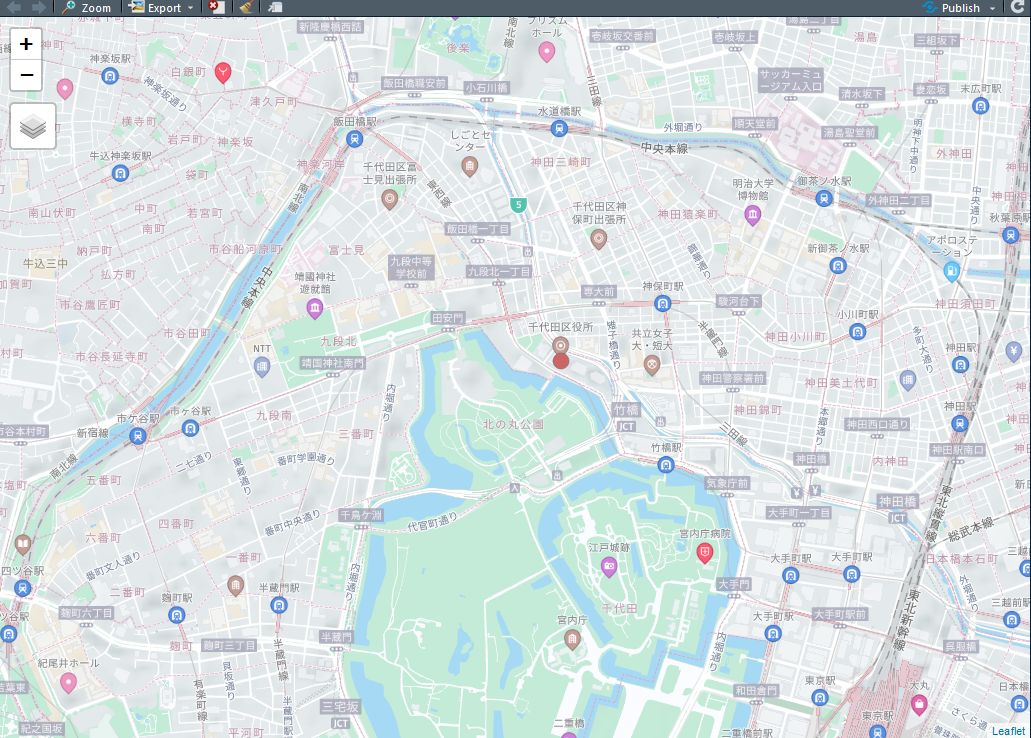
東京都でジオコーディングすると千代田区役所が代表点として返却されるようだ。
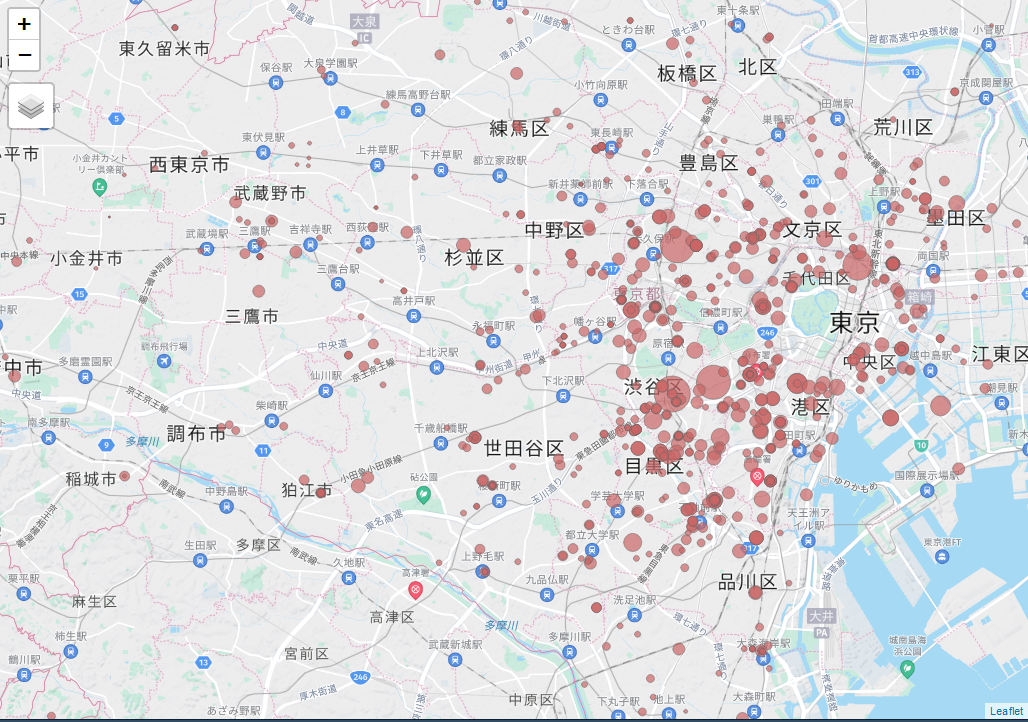
以下のコードでWebスクレイプで取得したデータの住所を元にジオコーディングし、返却された結果を元のデータに結合している。 返却されるデータには結合用にidが付与されるため、元のデータにも事前にidを付与している。 地図での表示には価格を元に比例シンボルで表示している。
# Geocode scraped data
dat <- rowid_to_column(dat) %>%
    rename(id = rowid)

geocoded <- geocode(dat$address) %>%
    right_join(dat, by = "id") %>%
    rename(geocoded_address = address.x, source_address = address.y) %>%
    select(id,
           rank,
           geocoded_address,
           type,
           name,
           source_address,
           line, station,
           walk_from_station, area,
           year_built, price,
           age_of_building, geometry)

tm_shape(geocoded) +
    tm_bubbles(size = "price", col = "#CC6666", alpha = 0.7, popup.vars = TRUE) +
    tm_basemap(server = basemap_endpoint)
当然だが都心部の方が価格が高い物件が多い。
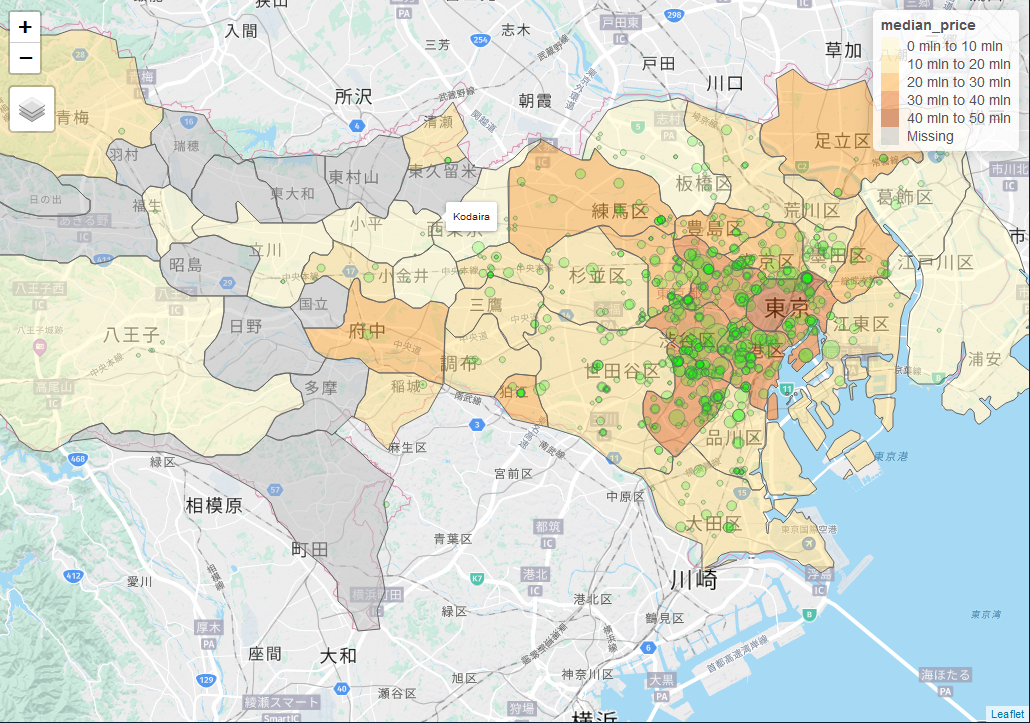
次に、各市区ごとの価格の中央値を地図上で可視化してみる。スタンフォード大学が日本の市区町村の行政区域のポリゴンを公開してくれているので、今回はそれを使った。
Second-level Administrative Divisions, Japan, 2015 | Stanford Digital Repository
GeoJSON形式でDLした行政区域のデータを読み込み、東京だけフィルターして使う。 sfパッケージのst_join関数で空間結合し、各市区町村の不動産価格の中央値を集計し表示している。
# Visualize median price for each city in Tokyo
admin_poly <- geojson_sf("share_w_host/here_advent_calendar_2023/stanford-ff095jm2871-geojson.json") %>%
    filter(name_1 == "Tokyo")

tm_shape(admin_poly) +
    tm_polygons(col = "#CC6666", alpha = 0.5) +
    tm_basemap(server = basemap_endpoint)

admin_medion_price <- st_join(admin_poly, y = geocoded) %>%
    group_by(name_2) %>%
    summarise(median_price = median(price))

tm_shape(admin_medion_price) +
    tm_polygons(col = "median_price", alpha = 0.5, ) +
    tm_shape(geocoded) +
    tm_bubbles(size = "price", col = "green", alpha = 0.2, popup.vars = TRUE) +
    tm_basemap(server = basemap_endpoint)
やはり都心三区を中心に価格が高い傾向があるが、練馬区や足立区、府中なども周辺に比べると高い中央値になっている。
一般化線形モデルによる統計解析
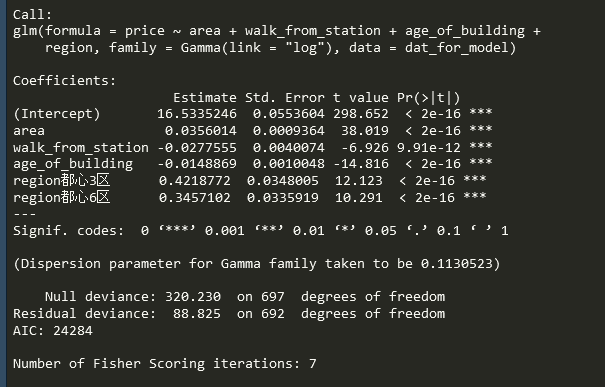
最後に一般化線形モデルで統計解析する。価格を目的変数にして、専有面積、駅からの徒歩時間、築年数、所在する市区町村を都心三区、都心六区、その他に分けたグループを説明変数にする。最寄駅を説明変数にしてもよいが、カテゴリーデータが多くなりすぎるとオーバーフィットしそうなので、上記三つにグループ分けして説明変数にすることにした。 モデルの確率密度関数は非負の連続データなので、とりあえずガンマ関数を使うことにする。
以下のコードで市区町村のグループ分け、一般化線形モデルでの統計解析、サマリの表示を行っている。
# Statistical analysis
dat_for_model <- st_join(x = geocoded, y = admin_poly) %>%
    mutate(region = case_when(nl_name_2 == "千代田区" |
                              nl_name_2 == "中央区" |
                              nl_name_2 == "港区" ~ "都心3区",
                              nl_name_2 == "渋谷区" |
                              nl_name_2 == "新宿区" |
                              nl_name_2 == "文京区" ~ "都心6区",
                              .default = "その他"))

model <- glm(price ~ area + walk_from_station + age_of_building + region,
             data = dat_for_model,
             family = Gamma(link = "log"))
summary(model)
結果は以下の通りだ。
以下のコードでモデルを元に予測した価格を表示し、残差を確認している。
# Prediction
predictions <- exp(predict(model, newdata = dat_for_model, type = "link"))

# Combine predictions with original data
pred_data <- cbind(dat_for_model, pred_price = predictions)

# Regression Plot
ggplot(pred_data, aes(x = area, y = pred_price)) +
    geom_point(aes(y = price), color = "#CC6666", alpha = 0.5) +
    geom_point(aes(y = pred_price), color = "lightgreen", alpha = 0.5) +
    geom_smooth(method = "glm", formula = y ~ x, se = FALSE, color = "grey", method.args = list(family = "Gamma")) +
    labs(x = "Area",
         y = "Predicted Price") +
    theme_economist_white()

# Residual Plot
residuals <- residuals(model, type = "deviance")
ggplot(pred_data, aes(x = pred_price, y = residuals)) +
    geom_point(color = "orange", alpha = 0.5) +
    geom_hline(yintercept = 0, linetype = "dashed", color = "blue") +
    labs(x = "Predicted Price",
         y = "Residuals") +
    theme_economist_white()
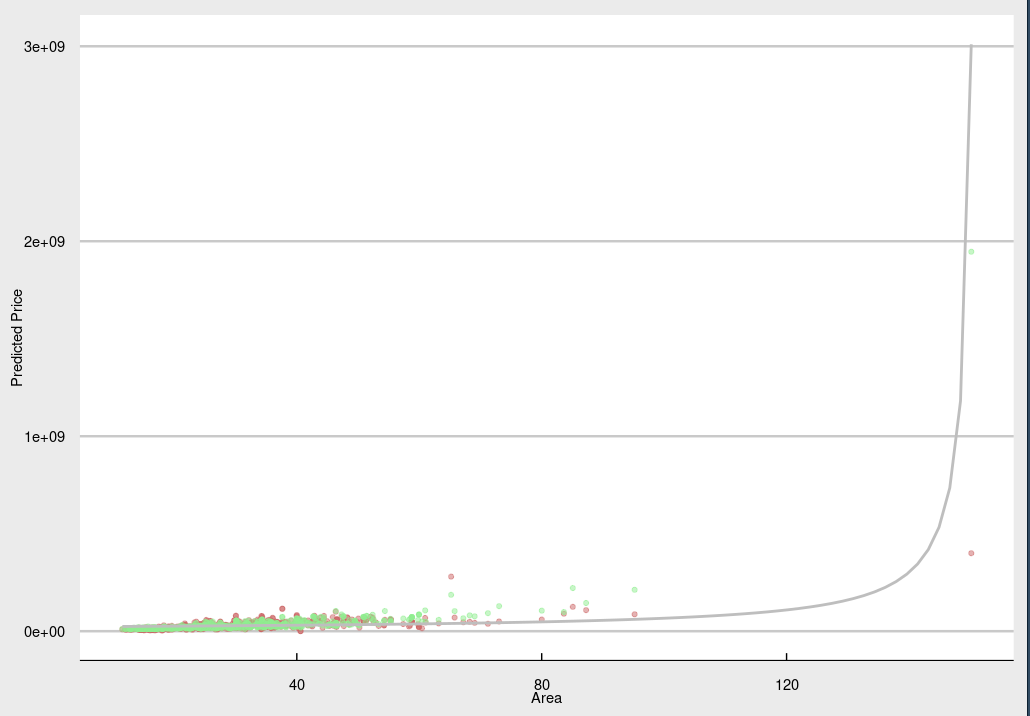
予測した価格はピンク色、実際のデータは緑色のドットで表示しているが、専有面積が大きくなると価格が一気に上昇するモデルになっている。おそらくは都心にある外れ値のデータが影響しているのだろう。
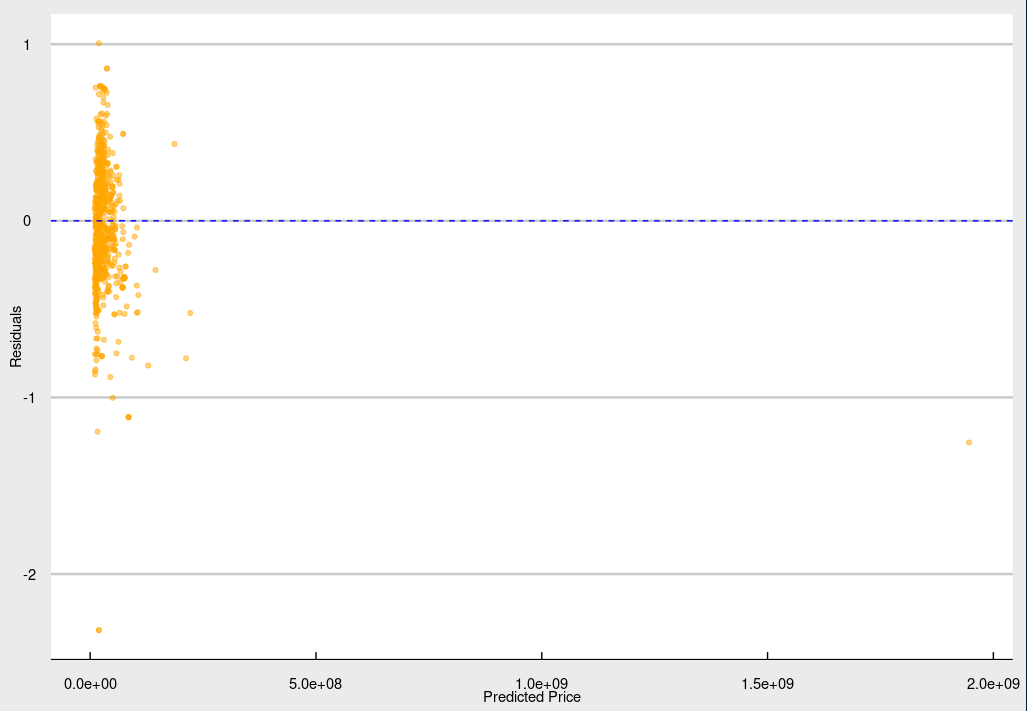
残差プロットを見ても外れ値が存在することがわかる。ガンマ関数は外れ値に対してロバストではないので、他の確率密度関数を用いるか外れ値の処理をする方がよさそうだ。
とりあえず今回はここまで。
Overture MapsのデータをRで可視化する
Overture Mapsのデータが先月公開されたので軽く可視化してみる。 overturemaps.org
Parquet形式で提供されているようで、以下のツールを使ってデータを取得するサンプルがGitHubで公開されている。
3つめのDuckDBはRのパッケージがあるようだ。
最近Rを触っていないしとりあえずローカルの環境で完結するので今回はDuckDBを使う。
使用したパッケージ
DuckDBに接続し、データをダウンロードする
データベースのインスタンスを作成し接続する。
con = dbConnect(duckdb(), dbdir = ":memory:")
duckdb() でDBのインスタンスを作成するが、dbdir=":memory:" とすることでメモリ上に作成することができる。
今回はデータをダウンロードしたらそれ以降は使わないので、メモリ上に作成することにした。
次のコードでデータをローカルにコピーするSQLを実行する。
dbExecute(
    con,
    "
    INSTALL spatial;
    INSTALL httpfs;
    INSTALL json;
    LOAD spatial;
    LOAD httpfs;
    LOAD json;
    COPY (
        SELECT
            type,
            subType,
            localityType,
            adminLevel,
            isoCountryCodeAlpha2,
            JSON(names) AS names,
            JSON(sources) AS sources,
            ST_GeomFromWkb(geometry) AS geometry
            FROM read_parquet('s3://overturemaps-us-west-2/release/2023-07-26-alpha.0/theme=admins/type=*/*', filename=true, hive_partitioning=1)
            WHERE adminLevel = 2
            AND ST_GeometryType(ST_GeomFromWkb(geometry)) IN ('POLYGON','MULTIPOLYGON')
        ) TO 'countries.json'
    WITH (FORMAT GDAL DRIVER 'GeoJSON');
    "
)

dbDisconnect(con)
DuckDBのエクステンションが必要になるので、spatial、httpfs、jsonの3つをインストール・ロードしている。 クエリはGitHubで公開されているサンプルをそのまま使うことにした。
サンプルではフォーマットをParquetではなくGeoJSONにしているので、これParquetでダウンロードしたらGeoParquetじゃないってオチだろ、と思ったら案の定そのとおりでGitHubにdiscussionが上がっていた。
そのうちGeoParquetでDLできるようになるとは思うが、今後に期待。
ダウンロードができたらもう不要なのでDBとの接続は切っておく。
GeoJSONを読み込んで可視化
次のコードでデータをsf形式で読み込む。 面積だけ計算し、使わなさそうなカラムは削除した。
countries <- st_read("countries.json") %>%
    mutate(area = st_area(.$geometry)) %>%
    mutate(area_km2 = set_units(area, km2)) %>%
    select(isocountrycodealpha2, area_km2)
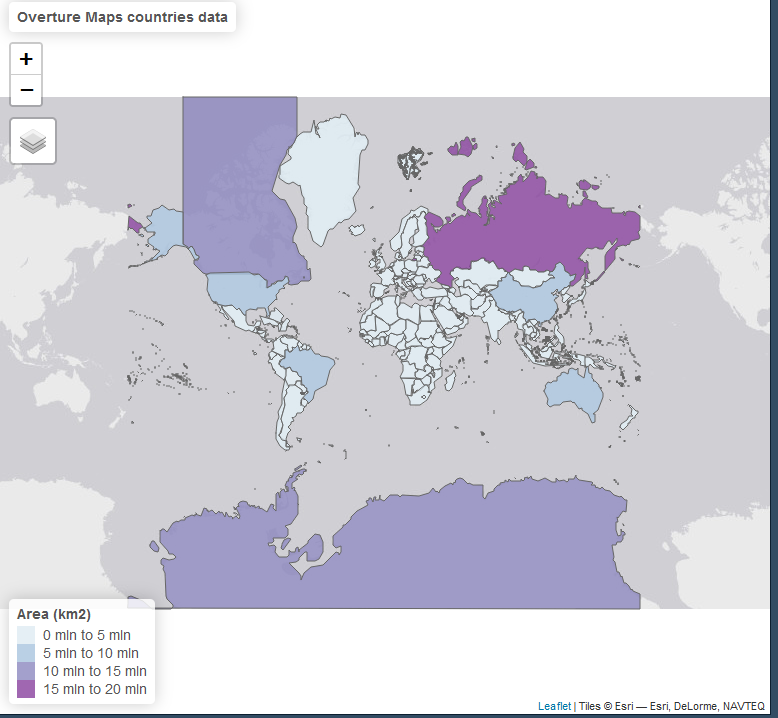
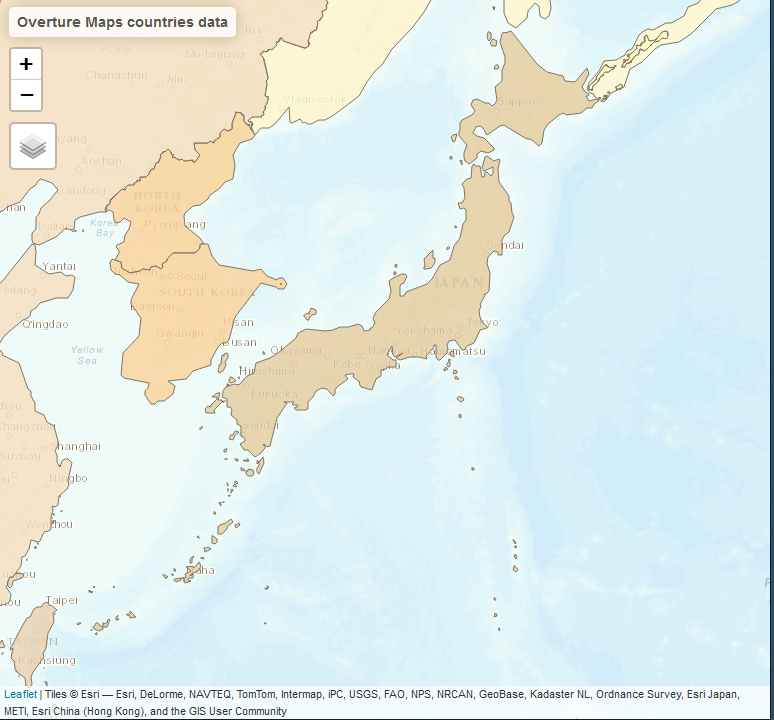
可視化にはtmapを使って面積でchoropleth mapを作った。
tmap_mode("view")
tm_shape(countries) +
    tm_fill("area", palette = "Blues", alpha = 0.8) +
    tm_borders(col = "grey40", lwd = 0.4, lty = "solid") +
    tm_layout(title = "Overture Maps countries data", legend.title.size = 1, legend.text.size = 0.6) +
    tm_view(view.legend.position = c("left", "bottom"))
カナダが雑すぎるw
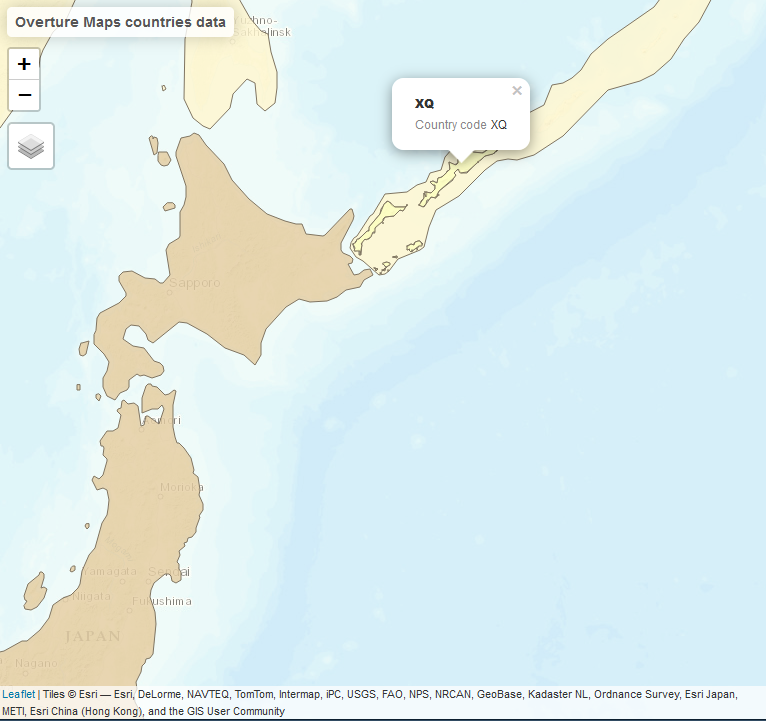
国別に塗り分けたマップも作成してみた。
tm_shape(countries) +
    tm_polygons("isocountrycodealpha2",
                alpha = 0.8,
                title = "Country code",
                popup.vars = c("Country code" = "isocountrycodealpha2")) +
    tm_style("classic") +
    tm_layout(title = "Overture Maps countries data", legend.title.size = 1, legend.text.size = 0.6) +
    tm_view(view.legend.position = c("right", "bottom"))
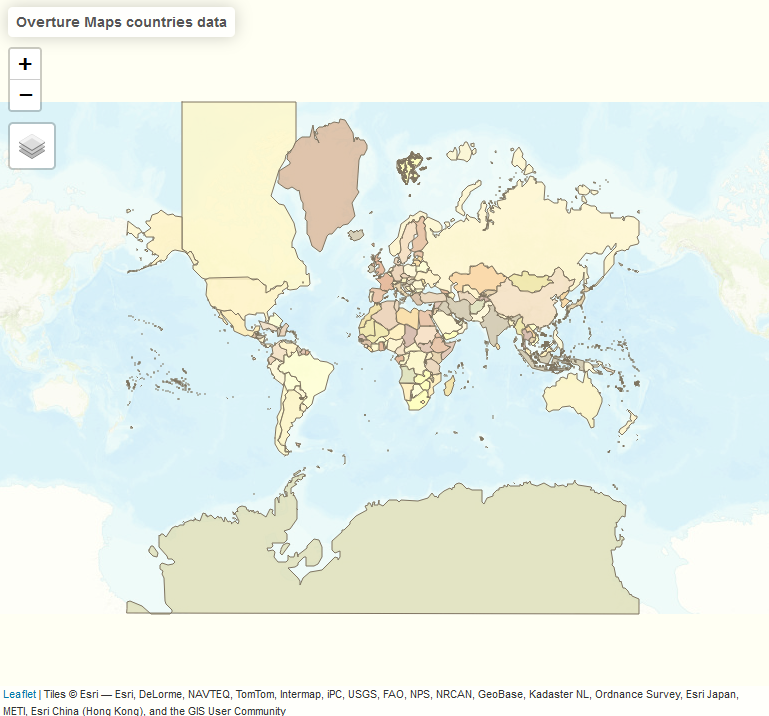
四国と本州が癒着してる。氷河期かな。
Country codeはISO 3166-1 alpha-2。北方領土みたいな係争地はuser assigned codeになってるっぽい。
Dockerを使ってHERE SKD for Pythonの環境を構築する
はじめに
本エントリーは、HERE Advent Calendar 2022の4日目の記事です。
今回はHERE Data SDK for Pythonの環境をDockerコンテナ上に構築する方法について書こうと思います。
HERE SDK for Pythonについて
HERE SDK for Pythonは、HERE Platform上のコンテンツにアクセスし、データの分析や視覚化を可能にするPythonのライブラリです。Jupyter NotebookやJupyter Lab上のウィジェットで地理空間データを可視化できるほか、Pandas (GeoPandas)を使ってデータ分析等が可能です。
詳しくは公式ドキュメント (開発者ガイド - HERE Data SDK for Python - HERE Developer) をご確認ください。英語版もあります。
HERE Platformやアカウント作成の手順については以下が参考になります。
環境
以下の環境で構築しています。LinuxやmacOSでも動作すると思いますが、試していません。
- Windows 11 Pro バージョン21H2 (OSビルド22000.795)
- Docker Desktop バージョン 4.15.0 (93002)
Micromambaについて
HERE SDK for Pythonの公式ドキュメントではCondaを使用してインストールする方法が掲載されていますが、今回はMicromambaのイメージをベースにして構築します。
MambaはC++で実装されたConda環境を管理するCLIツールです。MicromambaはMinicondaみたいなものです。並列でパッケージファイルをダウンロードするのでCondaに比べてパッケージのインストールがかなり速くなります。
Dockerfile等を作成
以下のようなディレクトリ構成でDockerfile等を配置します。
here-pysdk/
   ├ Dockerfile
   ├ docker-compose.yml
   ├ env.yml
   └ credentials/
         └ credentials.properties
- 今後拡張するかもしれないので、docker-compose.ymlを書いています。
- Docker-compose.yml内ではvolumeの設定を行っています。任意のホストのディレクトリとコンテナ上のディレクトリを紐づけてください。: の左側にホストマシンの任意のディレクトリを、右側にコンテナ上のディレクトリを指定します。
volumes:
\\wsl$$\Ubuntu\home\user_xxx\data_in_host:/home/mambauser/data_in_container
- コンテナ上のディレクトリは、data_in_containerの部分は任意のものに変更可能ですが、Dockerfile内で設定しているWORKDIRと同じディレクトリ名にしてください。
- Dockerfile内ではmatplotlib等でグラフを作成する際に日本語が文字化けしないように日本語環境の設定も行っています。
- env.ymlには必要なPythonのライブラリを記載します。HERE SDK for Pythonのライブラリもここに記載しておきます。
- credentials.propertiesは後述するHERE Platfromの認証情報を記載したファイルです。このファイルをコンテナ内のディレクトリに配置する必要があるので、コンテナ作成時にコンテナ内にコピーします。
詳細はGitHubからご確認ください。 github.com
HERE PlatformのCredential fileについて
HERE SDK for Pythonを利用するにはHERE Platformの認証情報が記載されているCredential fileをコンテナ上のディレクトリに配置する必要があります。公式ドキュメントにも記載がありますが、ここではスクリーンショット付きで説明します。
Credential fileは以下の手順でHERE Platformからダウンロードできます。
- HERE Platform Applications and Keysにアクセス
- [新しいアプリを登録]をクリック
 \
- [OAuth 2.0]をクリックし、[資格情報を作成]をクリック

- 認証情報が作成されるので、[ダウンロード]をクリックし上述のcredentialsディレクトリ内に保存

起動
docker-compose upで起動します。Jupyter Labが起動するので、ターミナルに表示されたURLをブラウザにコピペするなどしてアクセスしてください。
サンプルコード等
HERE SDK for Pythonのサンプルコードも公開されています。
開発者ガイド - HERE Data SDK for Python - HERE Developer
以下のようにウィジェット上で地図を表示することもできるようになっています。

mapplotlibを使う際などの日本語表示もできるようになっています。

その他注意点等
Dockerfile等は適当に改変していただいて構いません。GitHubに上げる際は.gitignoreにcredentials/を追加して認証情報を共有しないようにしましょう。
DockerでCmdStanが使えるRStudio Server環境を作った話
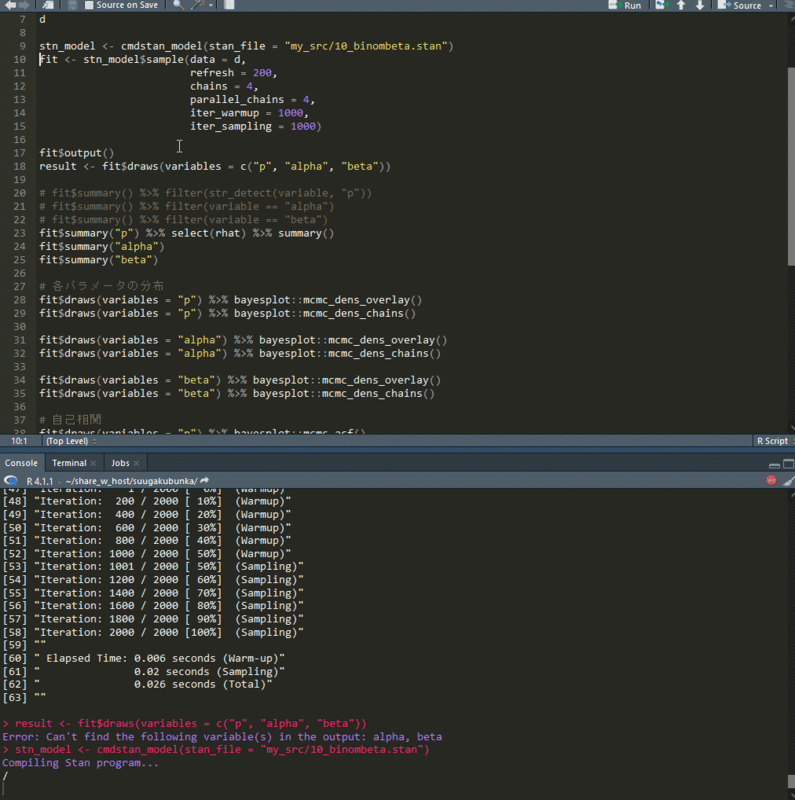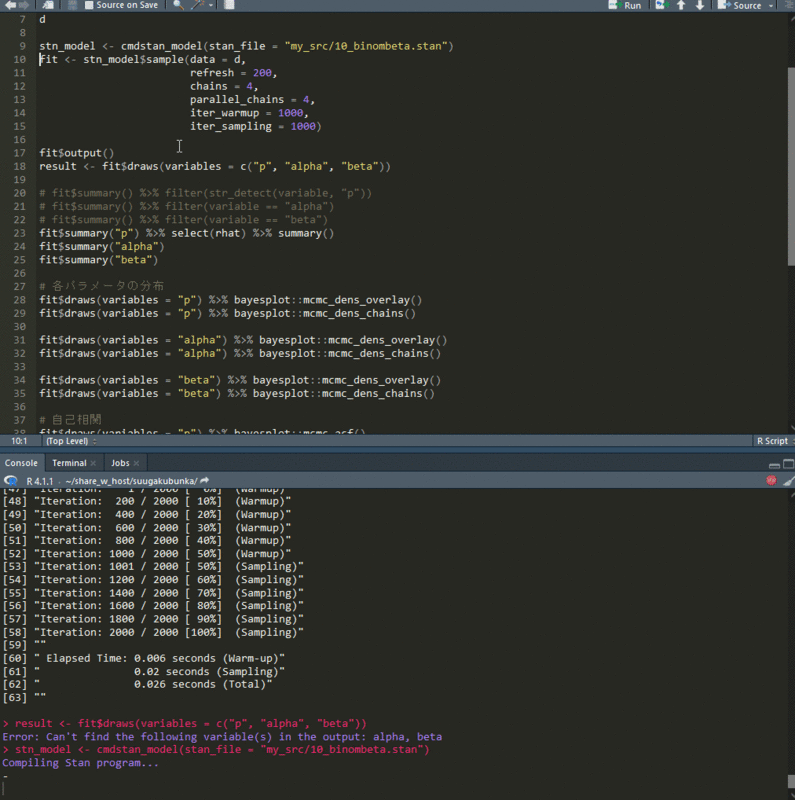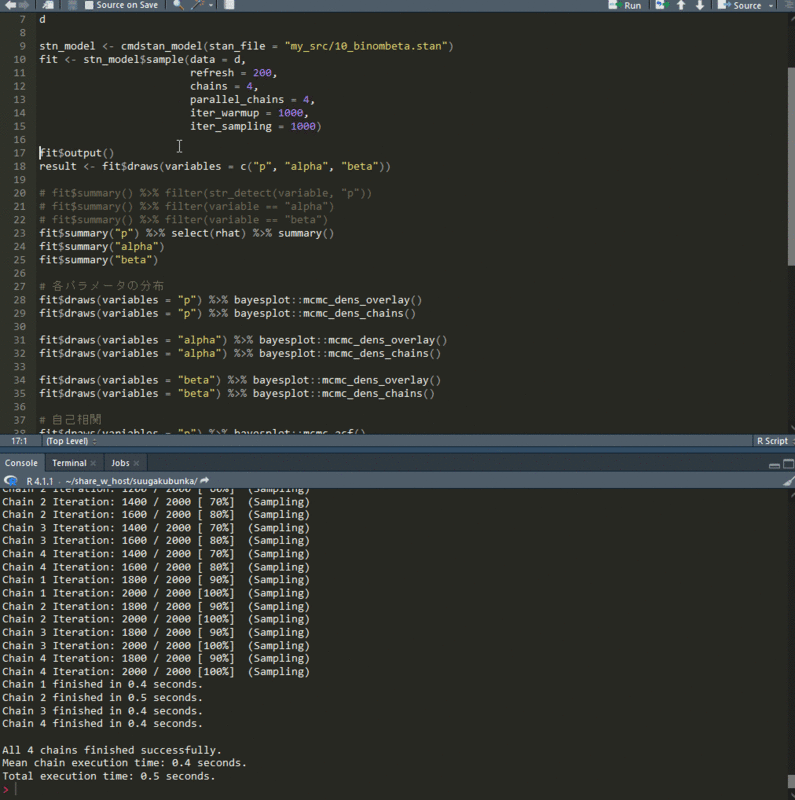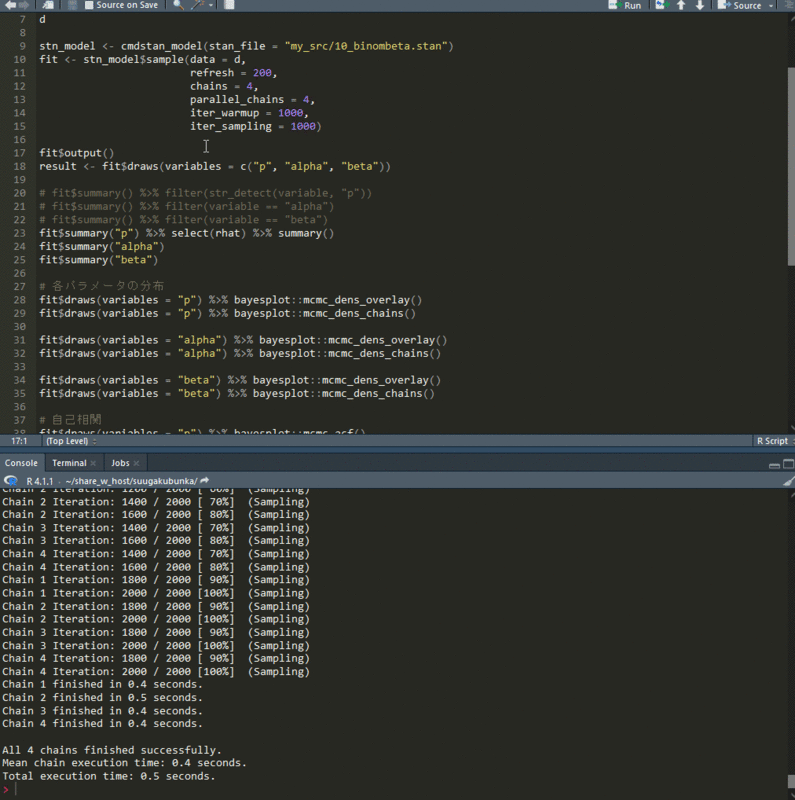
ベイズ統計を最近また勉強しはじめたのでDockerを使ってRStudio ServerでCmdStanが利用できる環境を作った。
環境を作る上で実現したかったことは以下のとおり。
- rocker/geospatialをベースとする
- 日本のLocale設定
- CmdStanRがすぐ利用できる
- rstanはもうダメらしい
Dockerfile等
以下GitHubに置いてあります。
Dockerfileを書く際に工夫?した点は次のとおりです。
- Rstudioの設定ファイル (rstudio-prefs.json)
- 以下でコンテナ内のディレクトリにコピーしています。
COPY ./rstudio-prefs.json /home/rstudio/.config/rstudio/rstudio-prefs.json
- 以下でコンテナ内のディレクトリにコピーしています。
- Localeの日本語化
- 以下の記事を参考にさせていただきました。フォントはIPAexフォントを使わせていただいています。
- 各パッケージのインストール
- install2.rを使ってインストールしています。詳細を書いてくださっているわかりやすい記事があるので詳しくはそちらをご覧下さい。
- CmdStanRのGetting startedで使われているパッケージの他に、EDAが楽にできるDataExoloreもインストールしています。
- CmdStanRのインストールについては、以下のコードでレポジトリを指定しています。
install2.r --error --deps TRUE --repos https://mc-stan.org/r-packages/ cmdstanr
- 以下のコードで (1) CmdStanのインストールディレクトリの作成、(2) CmdStanのインストール、(3) ディレクトリ所有者を実行ユーザー(rstudio)に変更、を行っています。コンテナ起動後すぐにCmdStanRを使えます。
mkdir /home/rstudio/.cmdstanr/ \
&& Rscript -e "cmdstanr::install_cmdstan(dir = '/home/rstudio/.cmdstanr/', cores = 2)" \
&& Rscript -e "cmdstanr::set_cmdstan_path(path = '/home/rstudio/.cmdstanr/cmdstan-2.28.0')" \
&& chown rstudio -R /home/rstudio/
起動方法
docker-compose up した後、localhost:8787/にブラウザでアクセスしてください。
所感
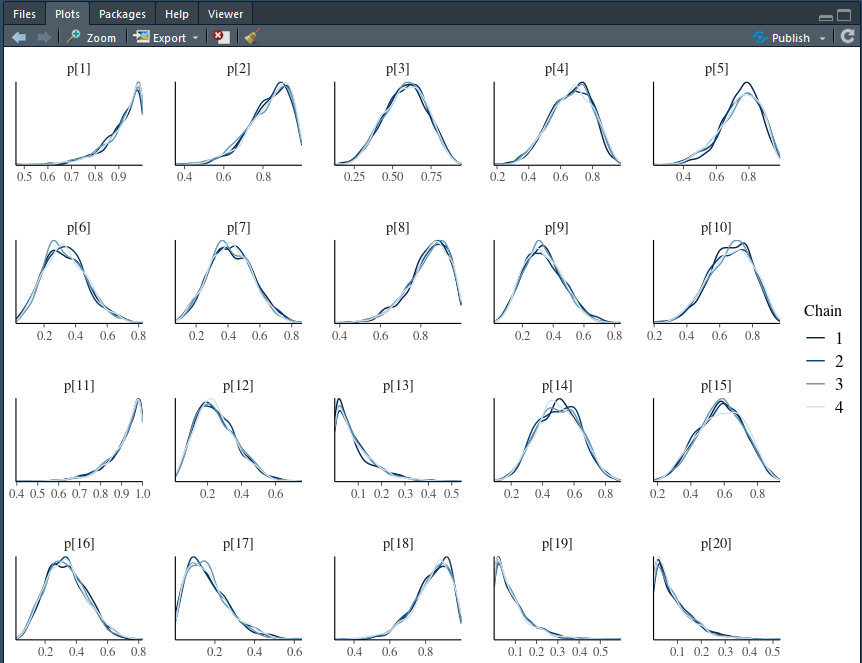
サンプリングがrstanよりずっと早い。
注意点
AnacondaからPipenvに乗り換えてArcGIS API for Pythonをインストールした。
Anacondaを使っていたが大規模な組織の利用は有償化されたとのことでPipenvに乗り換えた話。
- Anacondaが有償になっていた
- Anaconda(Miniconda)のアンインストール
- 公式からPythonをDL、インストール
- Pipenvのインストールと仮想環境作成
- 仮想環境の保存先をデフォルトから変更
- 仮想環境の再作成
- ArcGIS API for Pythonのインストールと動作確認
- Pipenv使ってみた所感
Anacondaが有償になっていた
転職して以降全くと言っていいほどコーディングする機会がなくなり、Pythonに関する情報もほとんど入ってこなくなったのだが、どうやらAnaconda(正確にはAnacondaパッケージリポジトリ)が200人以上の規模の組織で利用する際等は有償となっていたらしい。 Qiitaに詳しい情報をまとめてくれている記事がある。
個人的に使う分には全く問題ないが、仕事で使うことになった場合(あるのだろうか…)の代替は探しておきたい。ということで、調べたらPipenvを使うと良さそうなことが分かったので環境構築時のメモを残しておく。
といっても内容はほとんどが参考にした以下のブログと同じだ。
ただし、本稿では、加えて以下を行った。
- 仮想環境が作成される際の保存先を任意のディレクトリに変更
- ArcGIS API for Pythonのインストールと動作確認
ArcGIS API for PythonはEsriが提供するWeb GISにおいて、タスクの自動化や解析に利用できるAPIだ。
なお、OSはWindows 10 Proを使っている。
Anaconda(Miniconda)のアンインストール
自分の環境にはMinicondaがインストールされているので、以下の手順でアンインストールした。anaconda-cleanを使うとアンインストールした後に残ってしまう設定ファイルを消してくれる。
- Anaconda Powershell Promptで以下のコマンドを打ってanaconda-cleanをインストール
conda install anaconda-clean
- anaconda-cleanの実行
anaconda-clean
- コントロールパネルからMinicondaをアンインストール
公式からPythonをDL、インストール
説明不要だと思うので公式サイトのリンクだけ貼って割愛する。今回は最新の3.9.1をインストールした。
Pipenvのインストールと仮想環境作成
- Powershellで以下コマンドを打ってPipenvをインストール
pip install pipenv
- テスト用のプロジェクトディレクトリを作成し、ディレクトリを移動
- 仮想環境の作成
pipenv install
以上で仮想環境の作成が完了し、プロジェクトディレクトリ内には以下のファイルが作成される。
- Pipfile
- Pipfile.lock
前者ではプロジェクトでインストールされたパッケージが管理され、後者では依存関係やバージョンが管理されるようだ(参考)。condaでいうとpinnedファイルみたいなものかな。
仮想環境の保存先をデフォルトから変更
ここで作成された仮想環境がどこに保存されているのか知りたくなったので以下コマンドで調べた。
pipenv --venv
デフォルトだと以下のディレクトリに格納されるようだ。
- C:\Users[ユーザー名].virtualenvs
環境をいくつも作成するとストレージを圧迫するので、Dドライブに作成するようにしたい。
以下公式ドキュメントを見ると環境変数を設定すれば任意の場所に環境の保存先を変更できるようだ。
ドキュメントに従い、Windowsの環境変数を以下画像のとおり設定した。


上記の方法の場合、特定のディレクトリに作成した環境が全て保存されることになるが、プロジェクトディレクトリの配下に作成するように設定することもできるようだ。その場合、環境変数をPIPENV_VENV_IN_PROJECT、値をtrueに設定する。
仮想環境の再作成
以下コマンドで一度作成した環境を削除する。
pipenv --rm
pipenv installで環境を再度作成し、pipenv --venvで保存先を確認する。


ちゃんと環境変数で指定した保存先に作成されているようだ。
ArcGIS API for Pythonのインストールと動作確認
これでパッケージをインストールする準備も整ったので、ArcGIS API for Pythonをインストールできる。以下のコマンド一発で終了だが。
pipenv install arcgis

ArcGIS API for Pythonのドキュメントも、以前はなかったpipenvでインストールする方法が記載されていた。
インストールが終了したら環境に入って、Jupyter Notebookを起動して動作確認する。環境には以下のコマンドで入ることができる。
pipenv shell

Jupyter Notebookを起動してマップを表示する。
jupyter notebook
以下のコードでマップを表示させることができる。
from arcgis.gis import GIS
my_gis = GIS()
m = my_gis.map()
m.basemap = "topo-vector"
m
以下のGIFのような感じでマップが表示されればOKだ。

Pipenv使ってみた所感
個人的には、慣れの問題もあると思うが、condaの方が使いやすいという印象。condaはパッケージをインストールする際に、インストールされる依存パッケージが列挙されて各バージョンも確認できたのだが、それが表示されないと妙に不安になる。また、fastaiなど他にも利用したいライブラリでcondaの利用が推奨されているものがある。
ただ、Anacondaもわけわからん挙動を示したり、Anacondaのレポジトリ内にないパッケージもあったりしたので、一長一短だろうか。
しばらくはPipenvを使っていこうと思う。
WSL2、Docker、VS codeでWebマップ開発環境を構築する
はじめに
今回も自分用のメモだ。
Webマップの開発環境を変えたいと思いはじめてから大分時間が経ってしまった。
今まではHyper-Vで仮想マシンを作成していたが、WSL2も使えるようになったし、Dockerも触りたい。もう少しモダンな開発環境を作ろうということで以下の3つを使った開発環境を作ることにした。
- WSL2
- Docker
- VS Code
WSL2上でDockerを動かして、HostのマシンからVS Codeのエクステンションを使ってリモートでコンテナに接続する。Hostの環境を汚すことなく、VS Codeを使ってローカルで開発しているかのような感じで開発できるようだ。

出典:Developing inside a Container
この記事では上記3つのツールを使って開発環境を構築し、JavaScriptではじめるWebマップアプリケーションにあるMapbox GL JSを使ったWebマップのサンプルを動かすところまでやってみる。
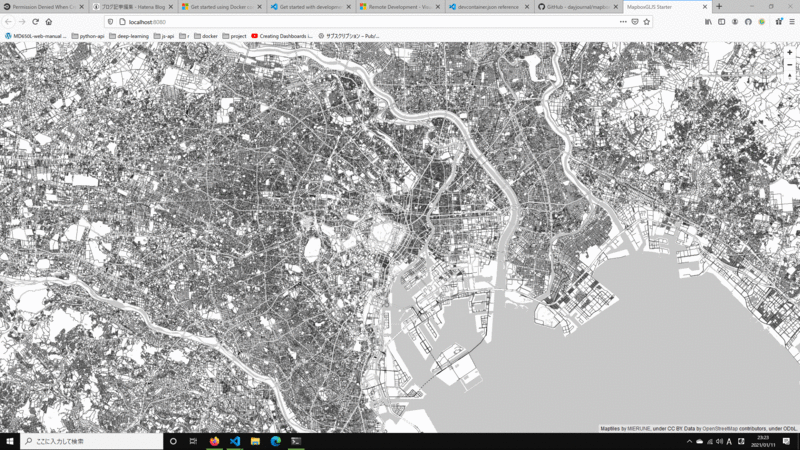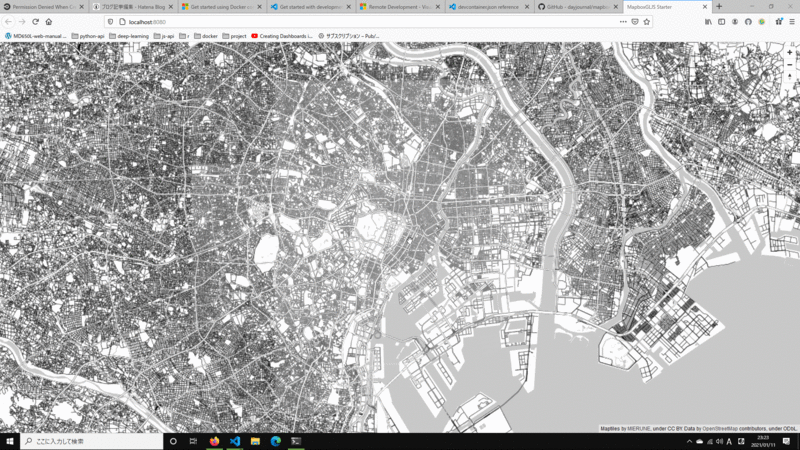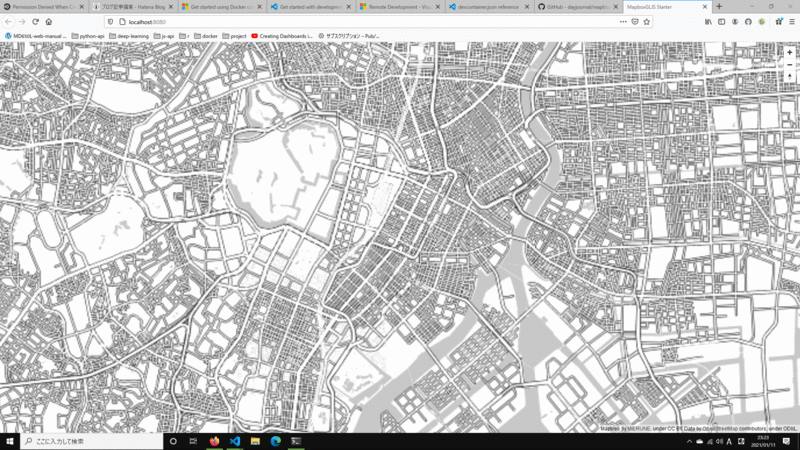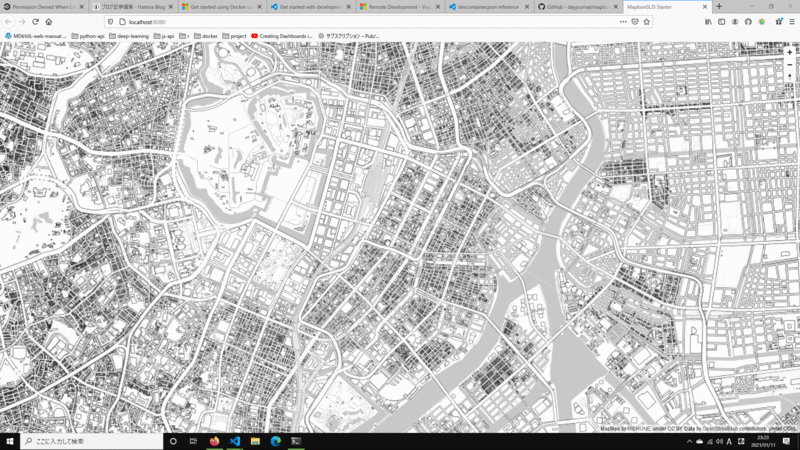
以下のような感じのアプリが動くのがゴールだ。
WSL2
WSL (Windows Subsystem for Linux) はWindows内でLinuxを実行できる仕組みらしい。詳しいことは知らない。
2になってファイルシステムのパフォーマンスが向上して、システムコールが完全に互換性を持ったためDocker等が動くようになったとのこと(参考)。Hyper-VでLinuxマシンを使うのと本質は変わらないようだが起動が圧倒的に早い。
WSL2のインストール
公式のドキュメントに従ってインストールした。Windows Insiders Programに入っていてプレビュー版のWindows 10を使っているともっと簡単なインストール方法があるようだが、今回はマニュアルでインストールした。 Windows 10のバージョンが1903以上、Build 18362以上であれば以下の手順でWSL2をインストールできる。
- WSLを有効化
- 管理者としてPowershellを起動し、以下のコマンドを実行
dism.exe /online /enable-feature /featurename:Microsoft-Windows-Subsystem-Linux /all /norestart
- 仮想マシン機能を有効化
- 管理者としてPowershellを起動し、以下のコマンドを実行
dism.exe /online /enable-feature /featurename:VirtualMachinePlatform /all /norestart
- Linuxカーネルの最新パッケージをダウンロードし実行
- WSL2をデフォルトのバージョンにする
- Powershellを起動し、以下のコマンドを実行
- wsl --set-default-version 2
- MSストアからLinuxのディストリビューションをインストールする
- 今回はUbuntuにした
さらにWindows Terminalをインストールすれば、Powershellだけでなく上記でインストールしたLinuxのターミナルも統合して扱えるので便利だ。前の記事ではAnaconda Powershell Promptを追加する方法を書いた。
Docker Desktop for Windowsのインストール
この記事を読む人には説明はほとんど不要だと思うので割愛する。インストーラーをダウンロードして実行すればよい。インストールしたら設定でWSL2 based engineを使うようにチェックを入れる。

VS Codeとエクステンションのインストール
公式サイトでインストーラーをダウンロードして実行するだけなので、VS Codeのインストールも割愛する。
エクステンションは、VS CodeからリモートでLinux環境やコンテナに接続するために以下をインストールする。
最後のRemote Developmentだけでも良さそうな気もしたが、とりあえず全部入れたった。
プロジェクトディレクトリの作成とGitHubのレポジトリのクローン
必要なツールがそろったのでLinuxマシンの中に入ってプロジェクト用のディレクトリを作成する。
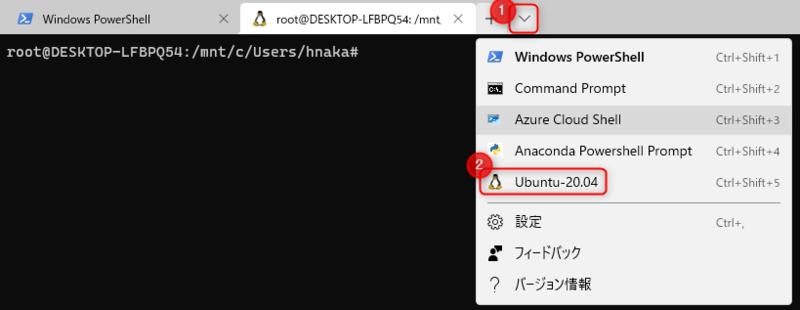
Remote - WSLのエクステンションを入れているので、UbuntuのターミナルからでもVS Codeが起動する。
Ctrl+Shift+`でVS Codeからターミナルを開くとUbuntuのターミナルにアクセスしており、HostのVS CodeからWSL2にリモートで接続できていることがわかる。

VS Codeで開いたターミナルに以下のコマンドを打ってサンプルアプリをレポジトリからクローンする。
git clone https://github.com/dayjournal/mapboxgljs-starter.git
コンテナでフォルダを開く
準備が整ったので、コンテナでフォルダを開く。以下手順に入る前にDocker Desktop for Windowsは起動しておこう。
- 左下に><のようなアイコンがあるのでクリックするとコマンドパレットが展開する
- Remote - Containers: Add Development Container Configuration Files... をクリック

- 作成するDockerコンテナのテンプレートがあらかじめ用意されており、リストから選択できるのでNode.JS の Version 14を選択する
- ディレクトリに.devcontainerフォルダが追加される
.devcontainerフォルダの中にはDockerfileとdevcontainer.jsonの二つのファイルが含まれている。
DockerfileはDockerイメージの設計書だが、devcontainer.jsonはVS Codeがどのようにコンテナにアクセスするかを規定する設定ファイルのようだ(詳細)。
VS Codeの右下にプロンプトが出てコンテナでフォルダを開きなおすか聞かれるので、Openをクリックする。

Dockerfileとdevcontainer.jsonの設定内容に従ってDockerイメージとコンテナが作成され、プロジェクトのディレクトリが自動でマウントされる。
アプリの起動
JavaScriptではじめるWebマップアプリケーションのREADMEに従ってパッケージをインストール、ビルド、アプリの起動を行う。
VS Codeのターミナルで以下のコマンドを実行する。ユーザーがnodeというユーザーになっているので、パッケージのインストールはsudoで行う。
cd mapboxgljs-starter/sudo npm installnpm run buildnpm run dev
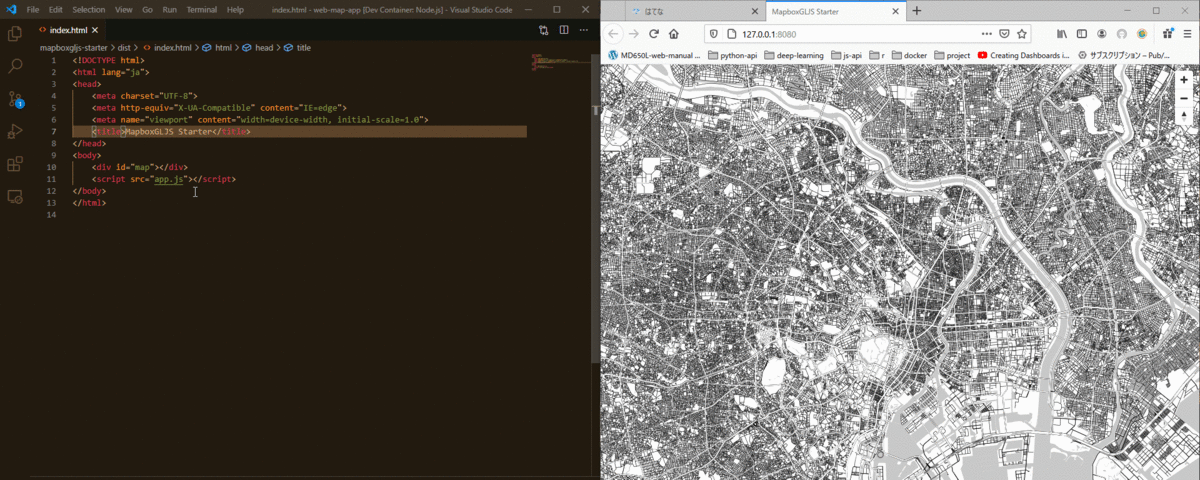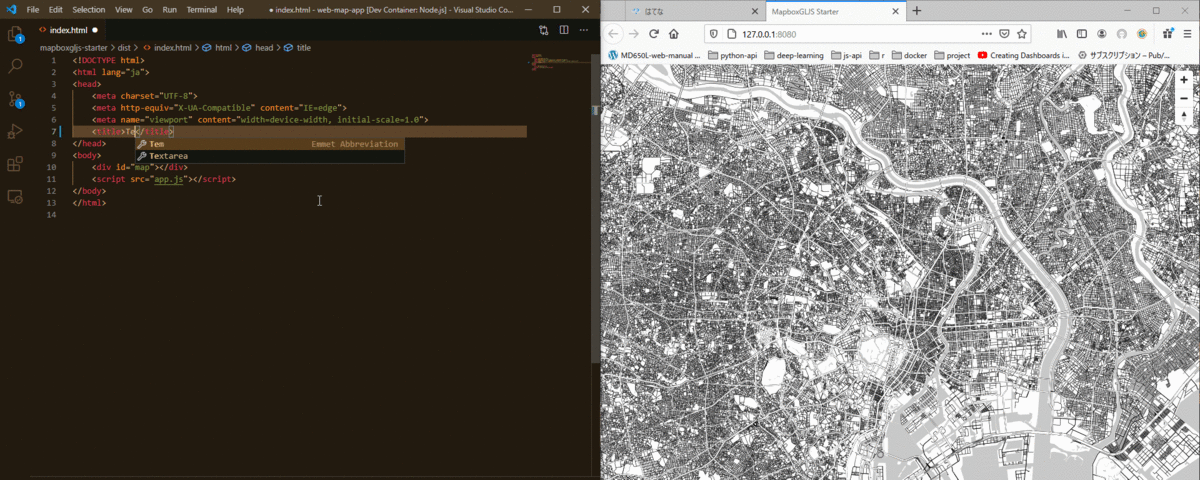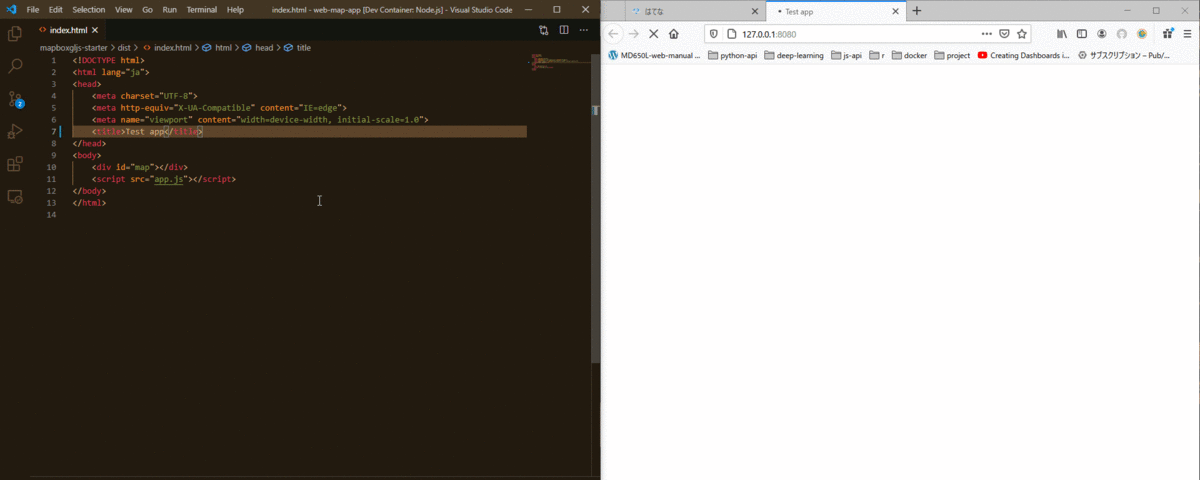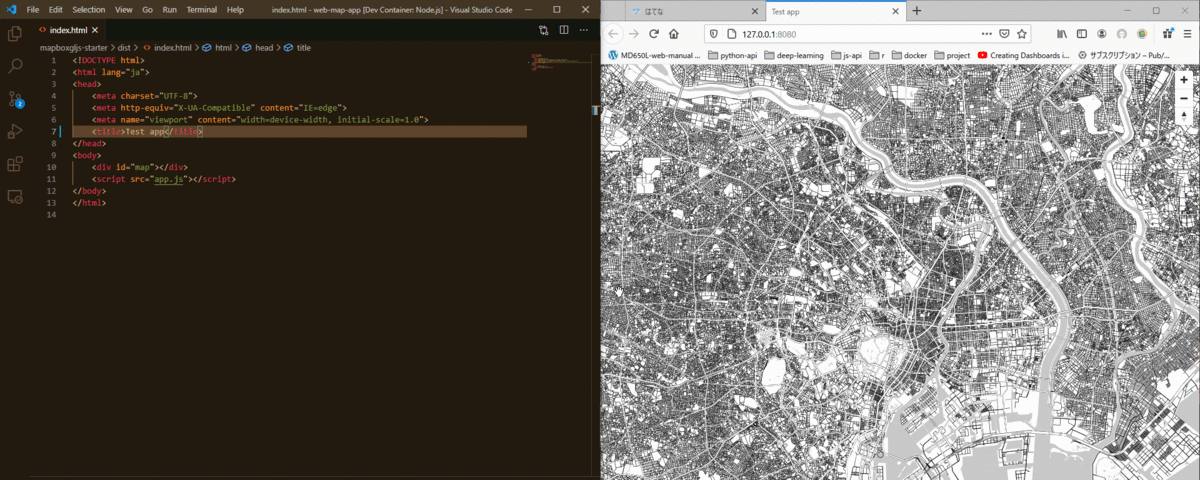
ブラウザで以下のようなWebマップのアプリが起動したら成功。
ソースコードの編集
このままだと編集権限がなく、アプリのカスタマイズができなかったので以下のコマンドを実行してソースコードのディレクトリのオーナーを変えた。
chown -R $USER:$USER .
スマートなやり方ではないのだろう。devcontainer.jsonを編集すれば上手く捌けそうだがどうだろうか。 その辺がわかったらまたブログでメモを残す。
以上で最低限の開発環境は構築できた。ソースコードを編集して保存すると以下のようにアプリ側に即反映される。いい感じだ。